

福田
はじめに
asyncioを使ったアプリケーションでは、外部APIの応答を待つ処理が中心でも、その前後のデータの変換や検証にはCPU時間が必要です。1つのイベントループは1つのスレッドで動くため、こうした処理が複数のCPUコアに自動的に分散されるわけではありません。CPU処理が増えると、ほかのコアに余裕があっても、1つのコアに負荷が集中して応答が遅くなることがあります。
free-threaded Pythonでは、スレッドごとにイベントループを動かすことで、これらの処理を複数のコアで並列実行できます。本記事では、この構成がどのような処理に有効かを確かめます。
よくある解決方法と、今回試したいこと
1つのコアに負荷が集中して応答が遅くなる場合、まずはプロファイリングで負荷の大きい箇所を調べ、不要な計算を減らすことから始めます。それでも処理が追いつかなければ、複数のプロセスへリクエストを分配する方法があります。ただし、プロセスごとに持つデータのメモリ使用量や、プロセス間で状態を共有する方法を考える必要があります。
計算部分をExecutorへ切り出す方法もあります。ただし、短いPython処理がリクエスト処理の各所にあると、どこで分けるか悩むことがあります。
今回は、I/
GIL
本記事では、従来のGILありPython
- 通常版でイベントループを増やすと速くなるのか
- free-threaded Pythonでは、どのような処理が速くなるのか
- HTTPサーバーのようなI/
O中心の処理でも効果があるのか - 接続が1つのイベントループに偏るとどうなるのか
- イベントループを増やす際に、何を共有してよいのか
- 1ループ、複数ループ、Executorをどのように使い分けるのか
なお、マルチプロセス構成との性能比較は行っていません。
また、asyncioを使うアプリケーションは、通常、1つのイベントループが理想的とされています[2]。今回は比較のため、通常版でもスレッドごとに独立したイベントループを動かします。ただし、通常版ではイベントループを増やしても、GILによるPythonコードの並列実行の制限は残ります。
本記事のサンプルコードと実行手順は、GitHub Gistにまとめています。
free-threaded Pythonを取り巻く変化
GILを無効にできるfree-threaded Pythonは、Python 3.
2026年のPyCon USとEuroPythonでも、free threadingやasyncioに関するトークがいくつかありました。個人的にコミュニティの関心の一部は
| トーク | 該当のセッション | 主な内容 |
|---|---|---|
| Free-threaded Python: past, present and future | PyCon US/ |
Pythonコア開発者のThomas Wouters氏によるトーク。スレッドセーフやデータ競合といった並行処理の設計が中心。2020年代中にはfree-threaded Pythonがデフォルトになるという話も |
| Demystifying the GIL | PyCon US | GILの役割と、GILによって表面化しにくかった共有メモリの競合 |
| Conquer multithreaded Python with Blanket | PyCon US/ |
スレッドの実行順序を制御し、競合を再現するテストツールBlanket |
| Making Python Faster with Free Threading and Mypyc |
PyCon US/ |
free threadingとmypycによる高速化と、メモリ割り当てや参照カウントの競合による制約 |
| Lock-Free Multi-Core Performance with Behavior-Oriented Concurrency | PyCon US | 共有データの所有権を管理する並行処理モデル |
| Rethinking AsyncIO from scratch for free-threaded Python | EuroPython | free-threaded Python向けにasyncioを再設計するパッケージ TonIO |
| Immutability: Fast and Safe sharing of Data across Subinterpreters | EuroPython | イミュータブルなデータをサブインタープリター間で共有し、コピーを減らす試み |
| Python Dicts: Past, Present, and Free-Threaded Future | EuroPython | free threadingへの対応に伴う辞書の内部実装の変化 |
また、asyncioとfree-threaded Pythonの組み合わせについて、次のガイドも公開されています。
- Python公式ドキュメントのasyncio and free-threaded Python
- 1スレッドにつき1つのイベントループを動かして複数コアを利用する構成
- Quansight Labs[3]の管理するfree threaded Pythonに関するガイドの Python free-threading guide
- 複数イベントループでWebスクレイピングを速くする例
この記事の対象読者
本記事は、asyncio.、await、Taskなどasyncioの基本的な使い方を知っており、Web API、クローラー、非同期ワーカーなどでasyncioを利用しているPython開発者を主な対象とします。とくに、次のような状況が気になっている方を想定しています。
- 1つのイベントループが1コアを使い切り、Taskの待ち時間や遅い側のレイテンシが増えている
- I/
O待ちの間ではなく、 awaitとawaitの間にある短いPython処理が積み重なっている - マルチプロセスやExecutorに加えて、free-threaded Pythonで利用できる選択肢を知りたい
free threadingの内部実装やC APIの知識は必要ありません。一方、asyncioを初めて使う方に向けた入門ではないため、コルーチンやイベントループの基本については、Python公式ドキュメントのasyncioの概念的な概要も併せてご覧ください。
free threadingやasyncio、並列処理に関連する話題は、本連載の過去記事でも紹介しています。
- PythonのGILと3.
13の実験的な新機能 「free threading」 を知る - Python 3.
14新機能:asyncioタスク可視化機能を使ってみよう - Python 3.
14新機能:InterpreterPoolExecutorで新しい並列処理を体験しよう
asyncioの並行処理を振り返る
まずは、1つのイベントループでI/
asyncioのイベントループには、実行可能になったTaskやコールバックが登録されています。イベントループは、それらを順番に少しずつ実行します。あるコルーチンがI/awaitすると、別の実行可能なコルーチンへ処理を切り替えます。
たとえば、100個のHTTPリクエストがレスポンスを待っていても、CPU上で100個のPythonコードが同時に実行されるわけではありません。多くの時間がI/
しかし、HTTPレスポンスを受け取った後に、次のような処理がある場合はどうでしょうか。
- JSONやHTMLをpure Pythonで解析する
- 受け取った値を検証・
変換する - テンプレートをレンダリングする
- 暗号学的ハッシュや圧縮などの計算をする
- Pythonで実装されたルールエンジンを実行する
これらのPythonコードを実行している間、同じイベントループ上のほかのTaskは待つことになります。1リクエストあたりの計算が短くても、多数のリクエストが重なると1コアがボトルネックになります。
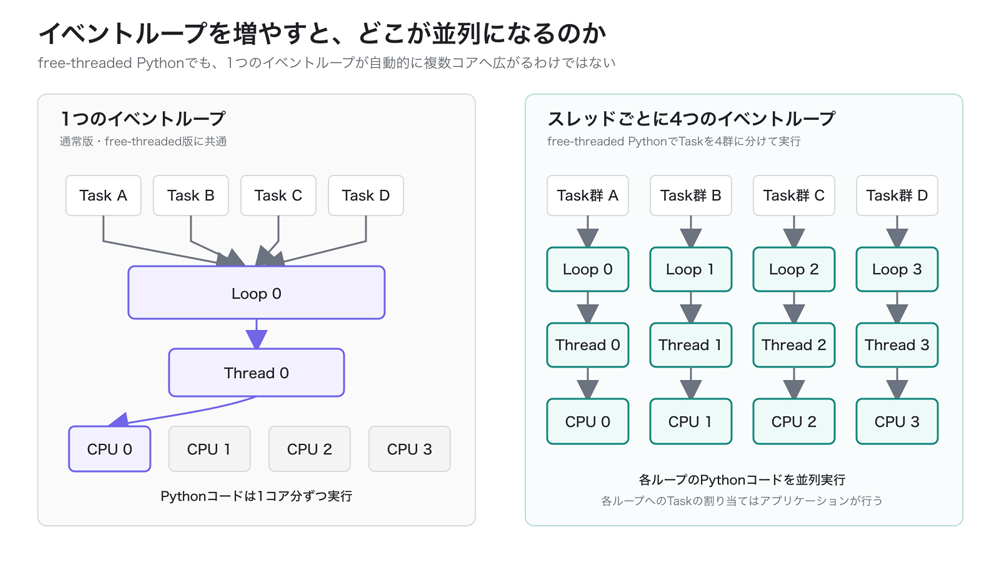
通常版とfree-threaded版、1ループと複数ループの関係を整理すると、次のようになります。
| Python | イベントループ | Pythonコードの実行 |
|---|---|---|
| 通常版 | 1ループ | 1スレッドで実行 |
| 通常版 | 複数ループ | 複数スレッドに分かれるが、GILにより同時実行は制限される |
| free-threaded版 | 1ループ | イベントループが1スレッドなので、基本的に1コアで実行 |
| free-threaded版 | 複数ループ | 各スレッドのPythonコードを複数コアで並列実行できる |
ポイントは、free-threaded Pythonはスレッドを並列実行できるようにするが、イベントループの分割や、接続・
1つのイベントループと、スレッドごとに複数のイベントループを動かす場合の違いを図にすると、次のようになります。右側は、実行するコルーチンを複数のグループへ分け、各ループでTaskを作成する構成です。HTTPサーバーでは、接続を各ループへ割り当て、そのループでリクエストを処理します。
uvで2種類のPythonを準備する
今回は、通常版とfree-threaded版で、同じ処理を1ループと複数ループで実行したときの実行時間と、HTTPサーバーの1秒あたりの処理件数を比較します。Pythonのインストールと実行にはuvを使用します。uvでは、バージョンの末尾にtを付けることでfree-threaded版を指定できます。
$ uv python install 3.14 3.14t
uvのfree-threaded Python対応については、公式ドキュメントのPython versions -- Free-threaded Pythonを参照してください。
使用中のPythonがfree-threaded buildか、実際にGILが無効になっているかを確認してみましょう。
"""free-threaded buildかどうかと、現在のプロセスのGILの状態を表示する"""

import sys
import sysconfig


print(f"free-threaded build: {bool(sysconfig.get_config_var("Py_GIL_DISABLED"))}")
print(f"GIL enabled: {sys._is_gil_enabled()}")
通常版をuvで実行します。
$ uv run --python 3.14 python check_gil.py
free-threaded build: False
GIL enabled: True
次に、free-threaded版を実行します。
$ uv run --python 3.14t python check_gil.py
free-threaded build: True
GIL enabled: False
sysconfig.は、free-threaded buildとしてビルドされたPythonかを表します。sys._is_は、そのプロセスで現在GILが有効かを返します。free-threaded buildでも、未対応のC拡張をimportした場合などにGILが再び有効になることがあるため、実際にGILなしで動いているかを確認するには、両方を調べてください。
スレッドごとにイベントループを動かす
まずは、4つのスレッドでそれぞれ独立したイベントループを動かすコードを見てみましょう。各スレッドのrun_がasyncio.でworker()を実行し、I/
"""各ワーカースレッドで独立したasyncioイベントループを1つずつ動かす"""

import asyncio
import threading
import time


def cpu_work(iterations: int) -> int:
    """整数演算を繰り返してCPUに負荷をかける"""
    value = 1
    for index in range(iterations):
        value = (value * 1_664_525 + 1_013_904_223 + index) & 0xFFFF_FFFF
    return value


async def worker(name: str) -> None:
    """I/O待ちをシミュレートした後にCPU処理を行い、結果を表示する"""
    await asyncio.sleep(0.1)
    result = cpu_work(1_000_000)
    print(f"{name}: thread={threading.current_thread().name}, result={result}")


def run_event_loop(index: int) -> None:
    """スレッド専用のイベントループを起動し、worker関数を実行する"""
    asyncio.run(worker(f"worker-{index}"))


def main() -> None:
    """4つのスレッドを起動し、すべての処理が終わるまでの時間を測る"""
    started = time.perf_counter()
    threads = [
        threading.Thread(
            target=run_event_loop,
            args=(index,),
            name=f"event-loop-{index}",
        )
        for index in range(4)
    ]
    for thread in threads:
        thread.start()
    for thread in threads:
        thread.join()
    print(f"elapsed: {time.perf_counter() - started:.3f} seconds")


if __name__ == "__main__":
    main()
run_関数は、asyncio.を使ってイベントループを作成します。この関数を4つのthreading.から呼び出すため、それぞれのスレッドに独立したイベントループが作られます。
通常版とfree-threaded版で実行時間を比較します。ファイルを保存したディレクトリで、次のコマンドを実行してください。
$ uv run --python 3.14 event_loop_per_thread.py
$ uv run --python 3.14t event_loop_per_thread.py
| 通常版 3. |
0. |
| free-threaded Python 3. |
0. |
この例では、各スレッドが0.
なお、この結果は筆者環境での1回の参考値です。次の節では、タスク数と処理内容を揃え、複数回測定して比較します。
マイクロベンチマークで特性を確認する
まずは、I/asyncio.でシミュレートします。次の3種類の処理について、1ループと4ループの実行時間を比較します。
- I/
O :asyncio.だけを実行するsleep() - CPU:pure Pythonの整数演算だけを実行する
- I/
O+CPU :I/O待ちの後に整数演算を実行する
1ループではすべてのTaskを1つのイベントループで実行します。4ループでは実行対象を4分割し、各スレッドのasyncio.で作るループに、それぞれのTaskを登録します。
以下は、複数ループで実行するrun_だけを抜き出したものです。引数tasksは総タスク数、loopsはループ数、workloadはI/stepsは各タスクの繰り返し回数を表します。今回は総タスク数 tasks=32、ループ数loops=4、steps=5 を指定して測定しました。
負荷を定義するWorkload、各タスクの処理を行うworker()、引数の設定と呼び出し側を含むコード全体は、asyncio_
def run_multi(
    tasks: int,
    loops: int,
    workload: Workload,
    steps: int,
) -> tuple[float, int]:
    """処理をスレッドごとのイベントループに分配し、時間を測る"""
    checksums = [0] * loops
    errors: list[Exception | None] = [None] * loops
    started = [0.0]

    def mark_started() -> None:
        """全スレッドの準備が整った時刻を記録する"""
        started[0] = time.perf_counter()

    barrier = threading.Barrier(loops, action=mark_started)

    def thread_main(index: int, worker_ids: range) -> None:
        """開始タイミングを揃え、担当する処理を独立したループで実行する"""
        try:
            barrier.wait()
            checksums[index] = asyncio.run(
                run_batch(
                    worker_ids,
                    steps=steps,
                    io_delay=workload.io_delay,
                    cpu_iterations=workload.cpu_iterations,
                )
            )
        except Exception as error:
            errors[index] = error

    threads = [
        threading.Thread(
            target=thread_main,
            args=(index, worker_ids),
            name=f"event-loop-{index}",
        )
        for index, worker_ids in enumerate(partition(tasks, loops))
    ]
    for thread in threads:
        thread.start()
    for thread in threads:
        thread.join()

    failures = [error for error in errors if error is not None]
    if failures:
        raise ExceptionGroup("Event loop threads failed", failures)

    return time.perf_counter() - started[0], _xor(checksums)
スレッド自体の起動時間が結果を大きく左右しないよう、すべてのスレッドを起動してthreading.へ到達した時点から計測しています。ただし、各スレッドでのイベントループ作成時間は計測に含めています。
動作環境と測定条件
動作環境は以下のとおりです。
- MacBook Air、Apple M2
- 8コア
(Performance 4コア、Efficiency 4コア) - メモリ24GB
- macOS 26.
6.1 - uv 0.
12. 5 - uvでインストールしたCPython 3.
14. 7、CPython 3. 14. 7t
ウォームアップを1回行った後、5回測定した中央値を使用しました。通常版とfree-threaded版のベンチマークは同時に動かさず、順番に実行しています。
通常版の結果
通常版では、複数のイベントループを4スレッドで動かしてもCPU処理は速くなりませんでした。Taskを分けても、Pythonコードを実行する際は同じGILを取得する必要があるためです。
I/asyncio.の待ち時間は1つのイベントループですでに並行化できており、スレッドやイベントループを増やしたコストだけが加わっています。
$ uv run --python 3.14 asyncio_multiloop_benchmark.py
| 処理の種類 | 1ループ | 4ループ | 速度比 |
|---|---|---|---|
| I/ |
0. |
0. |
0. |
| CPU | 1. |
1. |
0. |
| I/ |
1. |
1. |
0. |
free-threaded版Pythonの結果
free-threaded版では、CPU処理が4ループで3.
一方、I/
$ uv run --python 3.14t asyncio_multiloop_benchmark.py
| 処理の種類 | 1ループ | 4ループ | 速度比 |
|---|---|---|---|
| I/ |
0. |
0. |
0. |
| CPU | 1. |
0. |
3. |
| I/ |
1. |
0. |
3. |
ここまでの結果だけを見ると、
ローカルHTTPサーバーで試す
asyncioで小さなHTTP/
- keep-alive接続からHTTPヘッダーを読み取る
- 1ミリ秒のI/
O待ちをシミュレートする - pure Pythonの整数演算を実行する
- 8バイトのレスポンスを返す
このうち整数演算は、冒頭で挙げた検証や変換など、awaitとawaitの間にある短いPython処理を単純化したものです。演算量を変えながら、どの程度のCPU処理から複数イベントループの効果が見え始めるかを確認します。
測定には、次の3つのファイルを使います。各リンクからコード全体を取得できます。
- http_
server. :リクエストを受け取り、I/py O待ちとCPU処理をシミュレートして応答するサーバー - http_
load_ :サーバーへリクエストを送り、処理件数と応答時間を測定するクライアントclient. py - http_
benchmark. :サーバーとクライアントを別プロセスで起動し、1ループと4ループの測定結果を集計。サーバーの終了処理も行うpy
クライアントを別プロセスにするのは、サーバーと同じGILやイベントループを使わないようにするためです。デフォルトでは、64本のkeep-alive接続から1回の測定につき合計1,000リクエストを送ります。
HTTPサーバーである http_ の中心部分は次のとおりです。io_はI/cpu_は整数演算回数です。呼び出し側のhttp_は、デフォルトで--io-delay 0.と--cpu-iterations 20000をサーバーへ渡します。
async def handle_connection(
    reader: asyncio.StreamReader,
    writer: asyncio.StreamWriter,
    *,
    worker_index: int,
    io_delay: float,
    cpu_iterations: int,
) -> None:
    """接続を再利用し、I/O待ちとCPU処理をシミュレートして応答する"""
    request_number = 0
    try:
        while True:
            try:
                await reader.readuntil(b"\r\n\r\n")
            except (asyncio.IncompleteReadError, asyncio.LimitOverrunError):
                break

            if io_delay:
                # 外部APIなどの応答を待つ時間をシミュレートする
                await asyncio.sleep(io_delay)
            # データの検証・変換などに相当するCPU処理をシミュレートする
            result = burn_cpu(cpu_iterations, seed=request_number)
            body = f"{worker_index:02x}{result & 0xFF_FFFF:06x}".encode("ascii")
            writer.write(RESPONSE_PREFIX + body)
            await writer.drain()
            request_number += 1
    finally:
        writer.close()
        await writer.wait_closed()
測定値の読み方
結果を見る前に、本記事で使う性能測定の用語を整理しておきましょう。
- rps
(requests per second) :1秒間に処理できたリクエスト数です。たとえば400rpsなら、1秒あたり約400リクエストを処理したことになります。値が大きいほど、多くのリクエストを処理できます。 - レイテンシ:1つのリクエストを送ってからレスポンスを受け取るまでの時間です。本記事ではミリ秒
(ms) で表し、値が小さいほど短時間で応答しています。
レイテンシはリクエストごとに異なるため、測定結果を短い順に並べ、パーセンタイルという値で表します。
- p50:50%のリクエストがこの時間以内に完了。リクエストの処理時間の中央値にあたり、普段の応答時間を見る目安です。
- p95:95%のリクエストがこの時間以内に完了。残り5%はこれより時間がかかっており、遅い側の応答を見る目安です。
- p99:99%のリクエストがこの時間以内に完了。残り1%という、さらに遅い応答の様子がわかります。
たとえばp50が50ms、p95が170msなら、半数は50ms以内に完了した一方で、遅い側のリクエストは170ms近く待っていることがわかります。平均値だけでは、このような一部の遅いリクエストを見落とすことがあります。本記事では、rpsは大きいほど、p50、p95、p99は小さいほどよいと読んでください。
クライアントは、64本の接続それぞれが応答を受け取ってから次のリクエストを送ります。測定の開始・
このサーバーは、標準ライブラリだけでasyncioの特性を確認する検証用の実装です。HTTP仕様を完全に実装した実用サーバーではありません。
複数ループを作ったのに速くならない
測定には、サーバーとクライアントをそれぞれ別プロセスで起動するhttp_を使います。1つのターミナルから実行すると、1ループと4ループを順に測定し、サーバーの終了まで行います。サーバーとクライアントを別々のターミナルで起動する必要はありません。
最初は、asyncio.のreuse_を使い、4つのイベントループが同じポートで待ち受ける構成にしました。
これは、複数のソケットで同じポートを共有するためのOSのソケットオプションSO_を使う指定です。筆者としては、OSが64本の接続を4つのイベントループへ分配してくれると期待していました。
現在のコードで同じポートを共有する構成を試すには、3つのPythonファイルを同じディレクトリに保存し、次のコマンドを実行します。--accept-strategy reuse-portでポートを共有し、--requests 256 --rounds 1で256件の測定を1回行います。測定前には、デフォルトで100件のウォームアップを行います。
$ uv run --python 3.14t http_benchmark.py --accept-strategy reuse-port --requests 256 --rounds 1
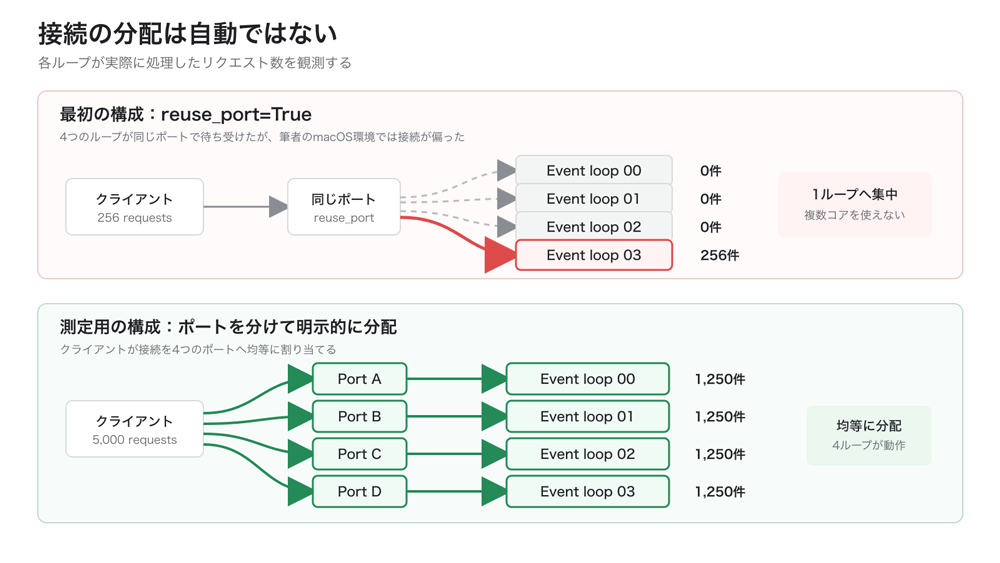
ところが、free-threaded版で256リクエストを送っても、rpsは1ループの611.
原因を調べるため、HTTPレスポンスへイベントループのIDを埋め込み、各ループが処理したリクエスト数を数えました。
| ループ数 | 実行ループ | リクエスト数 |
|---|---|---|
| 1ループ | 00 | 256 |
| 4ループ | 03 | 256 |
4ループを作成していましたが、筆者のmacOS環境では、全リクエストを最後に作成したイベントループ03が処理していました。ほかの3ループには接続が届いていないため、free-threaded Pythonでも速くなりません。
これは今回のmacOS環境と実装での結果です。SO_の接続分配はOSによって異なるため、Linuxなどでも同じ結果になるとは限りません。ただし、
接続を4つのイベントループへ分配する
イベントループ自体の性能を比較するため、各ループを別のローカルポートで待ち受けさせ、クライアントが接続を4つのポートへ均等に割り当てる構成へ変更しました。実運用でロードバランサーの背後に複数のワーカーがある状態を単純化したものです。
ポートを分ける場合は、--accept-strategy sharded-portsを指定します。次のコマンドでは、1ループと4ループのそれぞれで100件のウォームアップ後、1,000件の測定を5回行います。
$ uv run --python 3.14t http_benchmark.py --accept-strategy sharded-ports --requests 1000 --rounds 5
この構成では1回1,000件を5回測定し、4つのイベントループはそれぞれ1,250件、合計5,000件のリクエストを処理しました。前節の256件は接続の偏りを調べた試行で、ここで示すのは性能測定5回分の合計です。両者は測定件数が異なるため、この内訳から確認するのは接続の分配状況です。
| 実行ループ | リクエスト数 |
|---|---|
| 00 | 1250 |
| 01 | 1250 |
| 02 | 1250 |
| 03 | 1250 |
最初に試した構成と、測定のために明示的に分配した構成を図にまとめます。イベントループの数ではなく、各ループへ実際に接続が届いているかが重要です。
通常版でHTTP処理を比較する
まずは、通常版3.
| 構成 | rps | p50 | p95 | p99 |
|---|---|---|---|---|
| 1ループ | 409. |
156. |
172. |
210. |
| 4ループ | 425. |
145. |
193. |
215. |
rpsは1.
free-threaded版PythonでHTTP処理を比較する
次に、free-threaded Python 3.
| 構成 | rps | p50 | p95 | p99 |
|---|---|---|---|---|
| 1ループ | 415. |
153. |
173. |
177. |
| 4ループ | 1,350. |
47. |
51. |
54. |
4ループにするとrpsは3.
通常版とfree-threaded版で接続の分配方法や処理内容は同じです。free-threaded版では、4つのイベントループでHTTPリクエスト後のPythonコードを並列実行できたため、rpsが改善し、それに伴ってレイテンシも短縮しました。
Python処理がどのくらいあれば効果が出るのか
HTTPサーバーはI/
I/
| CPU演算回数 | 1ループ | 4ループ | 速度比 | p95 |
p95 |
|---|---|---|---|---|---|
| 0 | 22,035. |
26,962. |
1. |
3. |
2. |
| 1,000 | 6,168. |
14,618. |
2. |
11. |
4. |
| 5,000 | 1,711. |
4,809. |
2. |
39. |
14. |
| 20,000 | 415. |
1,350. |
3. |
173. |
51. |
CPU演算を明示的に加えない場合でも、4ループのrpsは1.asyncio.だけのケースと異なり、HTTPではソケット処理、HTTPヘッダーの読み取り、Taskの実行、レスポンス生成などにもCPU時間を使います。それらが複数ループへ分散された効果と考えられます。
CPU処理を増やすほど、4ループによる効果は大きくなりました。
イベントループを増やせば増やすほど速くなるのか
free-threaded版で、CPU演算を20,000回に固定し、イベントループ数を変えました。
| イベントループ数 | 1ループに対するrpsの比 |
|---|---|
| 2 | 1. |
| 4 | 3. |
| 8 | 4. |
2ループではほぼ2倍、4ループ、8ループでも性能は向上しました。ただし、8ループにしても8倍にはなりません。
筆者環境のM2は、4つのPerformanceコアと4つのEfficiencyコアで構成されています。コアごとの性能差に加え、イベントループやスレッド、ソケットを管理するコストも影響すると考えられます。メモリ帯域や参照カウントの競合、同じマシンで動くクライアントの負荷も候補ですが、今回の測定では各要因の影響を切り分けていません。
イベントループ数は、論理CPU数をそのまま設定すればよいわけではありません。実際のアプリケーションと同じ処理内容、接続数、デプロイ環境で測定し、適切なイベントループ数を選んでください。
イベントループをまたいで共有してはいけないもの
Python 3.
- 1つのイベントループを複数スレッドで共有しない
- あるループで作成したTaskやFutureを、別スレッドから直接操作しない
asyncio.、Lock asyncio.、Event asyncio.をスレッド間の同期に使わないQueue - スレッド間のデータ受け渡しには
queue.などのスレッドセーフな仕組みを使うQueue - 別スレッドからループへ処理を登録する場合は、スレッドセーフなAPIを使う
別スレッドが所有するイベントループへコルーチンを登録するには、asyncio.を使用します。通常のコールバックであれば、loop.を利用できます。
"""別スレッドのイベントループへコルーチンを安全に登録する"""

import asyncio
import queue
import threading


async def calculate(value: int) -> int:
    """I/O待ちをシミュレートし、受け取った値の2倍を返す"""
    await asyncio.sleep(0.1)
    return value * 2


def run_event_loop(loop_queue: queue.Queue[asyncio.AbstractEventLoop]) -> None:
    """イベントループを作成してキューで渡し、停止まで動かす"""
    loop = asyncio.new_event_loop()
    asyncio.set_event_loop(loop)
    loop_queue.put(loop)
    loop.run_forever()
    loop.close()


def main() -> None:
    """別スレッドへ計算を依頼し、結果を受け取ってループを停止する"""
    loop_queue: queue.Queue[asyncio.AbstractEventLoop] = queue.Queue()
    thread = threading.Thread(target=run_event_loop, args=(loop_queue,))
    thread.start()

    loop = loop_queue.get()
    future = asyncio.run_coroutine_threadsafe(calculate(21), loop)
    print(future.result())

    loop.call_soon_threadsafe(loop.stop)
    thread.join()


if __name__ == "__main__":
    main()
この例では、ワーカースレッドがイベントループを作成し、queue.を使ってメインスレッドへループを渡しています。メインスレッドはrun_でcalculate()を登録し、戻り値のconcurrent.から結果を受け取ります。
42
最後にcall_でloop.を登録しています。loop.をメインスレッドから直接呼び出さない点に注目してください。
この例のfuture.は同期的に呼び出し元を待機させます。別のasyncioイベントループ上のコルーチンから利用する場合は、イベントループをブロックしない設計が必要です。
どの方法を選ぶか
free-threaded PythonでCPUを使いたい場合でも、常に複数イベントループが最適とは限りません。処理の特徴や分離の要件に応じて、最初に検討する方法を次の表にまとめます。
| 状況 | 最初に検討する方法 |
|---|---|
| 大部分がI/ |
1つのasyncioイベントループ |
| 一部の独立した同期関数だけがCPUを使う | free-threaded版のasyncio.やThreadPoolExecutor |
| 多数のリクエストがそれぞれI/ |
スレッドごとの複数イベントループ |
| 通常版でCPU処理を並列化したい | ProcessPoolExecutorやInterpreterPoolExecutor |
| 強いメモリ分離や障害分離が必要 | 複数プロセス |
たとえば、asyncioアプリケーション内に1つだけ重い画像変換関数があるなら、イベントループ全体を複数に分ける前にasyncio.で処理を移す方が単純です。
一方、HTTPリクエストごとに解析、検証、変換などの短いPython処理が何度も現れ、1つのイベントループが1コアを使い切っている場合は、処理全体を複数イベントループへ分ける価値があります。
まずプロファイラーやメトリクスでボトルネックを確認し、もっとも小さな変更から試すことをおすすめします。
実運用で検討すること
今回のベンチマーク結果を、そのままWebアプリケーションの性能として一般化することはできません。今回の測定では、クライアントが応答を受け取ってから次のリクエストを送るため、サーバーが遅くなると、クライアントが単位時間あたりに送信するリクエスト数も減ります。実サービスのように、サーバーの状態に関係なくリクエストが届き続けて待ち行列が伸びる状況は再現していません。実運用へ取り入れる場合は、少なくとも次の点を確認してください。
利用するライブラリのfree-threading対応
pure Pythonのコードは基本的にfree-threaded buildで動作しますが、C拡張が未対応の場合はimport時にGILが自動的に有効になることがあります。sys._is_を起動時のログやヘルスチェックで確認するとよいでしょう。
主要パッケージの対応状況は、 Compatibility Status Trackingで確認できます。
接続の分配
今回のSO_のように、イベントループを増やしても接続が偏れば性能は向上しません。ロードバランサー、ワーカーポート、ソケットの引き渡しなど、受け付けた接続をどのように各ループへ分配するかを決める必要があります。
rpsやCPU使用率だけでなく、ループごとの接続数、Task数、キューの長さ、レイテンシも観測してください。
共有状態とスレッドセーフ
複数のイベントループが同じPythonオブジェクトへアクセスする場合、GILがデータ競合を隠してくれるとは限りません。キャッシュ、カウンター、接続プール、ログハンドラーなどの共有状態を確認し、threading.、スレッドセーフなQueue、イミュータブルな値、スレッドごとの状態を使い分けてください。
終了処理と障害の扱い
複数イベントループでは、起動だけでなくgraceful shutdownも複数のスレッドへ伝える必要があります。あるループだけが停止した場合の検知、処理中Taskのキャンセル、接続の終了、例外の集約も設計に含めてください。
まとめ
本記事では、free-threaded Pythonでスレッドごとにasyncioイベントループを動かし、I/
1つのイベントループは、free-threaded Pythonでも自動的に複数コアへ広がりません。複数コアを使うには、複数スレッドで独立したイベントループを動かし、接続やTaskを各ループへ分配する必要があります。
今回のローカルHTTPベンチマークでは、通常版の4ループは1ループに対して1.
一方、最初に試したSO_の構成では、すべての接続が1つのイベントループへ集中し、free-threaded版でも速くなりませんでした。重要なのはイベントループの数ではなく、実際に接続やTaskが分配され、各ループがCPUを使えているかです。
asyncioはこれまで
まずは手元のasyncioアプリケーションで、イベントループが1コアを使い切っていないか、I/